
生成AIの普及によって、多くの企業がAI活用を前提とした業務改革に取り組むようになりました。そして現在、企業の関心は「生成AIを使うこと」から、「AIエージェントを業務で成果につなげること」へと移りつつあります。
2026年9月に開催されたSnowflake World Tour Tokyo 2026では、AIをビジネス成果につなげるためのデータ基盤に加え、企業固有のデータの意味やコンテキスト(文脈)をAIに理解できる形で提供する重要性が語られました。AIエージェントが複数システムを横断しながら業務を実行する時代においては、企業内に蓄積されたデータを適切に整理・管理し、AIが活用できる状態にしておくことが競争力を左右します。
本記事では、Snowflake World Tour Tokyo 2026の基調講演や国内企業の事例を踏まえ、AIエージェント時代に求められるデータ戦略と「AI-Readyデータ(※)」の考え方についてレポートします。
※本記事では、AIがデータの構造や意味、企業固有の業務ルールを正しく理解し、分析や業務実行に活用できる状態にあるデータを「AI-Readyデータ」として解説します。
この記事を読んでわかること企業のAI活用を加速する2つのAIエージェント「CoWork」と「CoCo」日産自動車、富士フイルムなど国内の先進企業によるSnowflake活用事例AI-Readyデータに必要な「データの品質」と「意味定義」の考え方
【この記事を書いた人】ITPNAVI編集部 加藤優子

ITPNAVI編集部の加藤です!
連載「カトウタイムズ」でさまざまなIT関連の最新情報を、
SCSK社員である私の視点で皆様にお届けしています。
Snowflake World Tour Tokyo 2026のテーマは、AIをビジネス成果につなげる
「Snowflake World Tour」は、Snowflake社が世界各地で開催するグローバルイベントです。最新の製品アップデートやAI活用のベストプラクティス、国内外の先進事例などが紹介される場として、世界中のデータ活用担当者やエンジニア、経営層から高い注目を集めています。
「Snowflake World Tour Tokyo 2026」は、昨年と同じく品川を会場とし、2026年9月10日~11日の2日間にわたって開催されました。登録者数は12,000人超、参加者は6,300人超と過去最大規模を記録し、日本市場におけるSnowflakeへの期待の高さをうかがわせるイベントとなりました。
今年のテーマは「Making AI Real for Business(AIをビジネスで「使う」から「成果を出す」へ)」です。生成AIブームを経て、多くの企業がAI活用に取り組むようになりましたが、実際にはPoCや部門単位の活用にとどまるケースも少なくありません。そうした中、本イベントではAIをいかに業務へ組み込み、継続的な価値創出につなげるかが大きなテーマとして掲げられました。
基調講演から読み解く、SnowflakeのAIエージェント戦略

会期1日目と2日目にそれぞれ行われた基調講演(Keynote)では、AIエージェント時代における企業データの重要性が強く語られました。その前提には、AIエージェントを導入するだけでは業務成果に繋がらないという現実があります。企業のデータが部門やシステムごとに分散していたり、データの意味や定義が統一されていなかったりすると、AIは十分な価値を発揮できません。こうした課題をクリアして「Agentic Enterprise(AIエージェントを前提とした企業)」となり、ビジネス上の成果を出すーSnowflake社はそのための4つの柱を示し、さまざまな新機能を紹介しました。
エンタープライズデータとコンテキスト
第一の柱は、企業データとコンテキストです。AIエージェントが業務で正しい判断を行うためには、「そのデータが何を意味するのか」を理解する必要があります。例えば、企業内で「売上」という同じ言葉が使われていても、受注ベースなのか、出荷ベースなのかなどによって意味は異なります。そこでSnowflakeは、データの所在や意味、信頼性を統合的に管理する仕組みを備えています。

まず「Horizon Catalog」は、企業内に存在するデータ資産の目録として機能します。Snowflake内のテーブルやビューだけでなく、Icebergテーブルや外部データベース、BIツールのメタデータまでを横断的に管理できる統合カタログです。どこにどのデータがあるのか、誰が利用できるのか、どのレポートやアプリケーションで利用されているのかを可視化し、AIや利用者が必要なデータを見つけやすくします。

続いて、「Horizon Context」は、そのデータに対して業務上の意味や文脈を与えるための仕組みです。先の例でいう「売上」とはどういうものなのかといったビジネス定義を「Semantic View」によって一元的に管理し、AIエージェントやBIツール、アプリケーションが同じ意味解釈で動作できるようにします。
一方で、Semantic Viewで整理されていないデータも数多く存在します。そこで登場するのが「Cortex Sense」です。Cortex Senseは、クエリ履歴や社内ナレッジなどのさまざまな情報をもとに、AIが企業固有の業務コンテキストを自動的に理解できるよう支援します。

また、こうしたデータ活用を安全に行う基盤として「Trust Center」があります。アクセス権限やセキュリティ設定、リスク状況などを一元的に可視化し、AIエージェントが参照するデータについてもエンタープライズレベルの統制を維持できるよう設計されています。
AIエージェント時代には、単にデータを蓄積するだけでは十分ではありません。AIが正しいデータを見つけ、その意味を理解し、安全に利用できる環境を整備することが重要になります。
AIモデルの選択とガバナンス
第二の柱は、AIモデルの活用とガバナンスです。生成AI市場では、GPTやClaudeをはじめとする大規模言語モデル(LLM)の性能向上が注目を集めています。しかし基調講演では、モデルそのものの性能よりも、企業がどのようにAIモデルを活用・管理していくべきかに焦点が当てられていました。実際の業務では、すべての処理に最高性能のモデルが必要なわけではありません。文書要約や問い合わせ対応、データ分析支援など、用途によって求められる性能やコストのバランスは異なります。
そこで紹介されたのが「Cortex AI Gateway」です。Cortex AI Gatewayは、
タスクごとに最適なLLMを選択するAI利用状況を可視化する外部ツールとの接続を統制する
といった役割を担います。
これにより、利用目的に応じて適切なモデルを選択し、コストと性能のバランスを取ることが可能になります。これは近年注目されている「AIトークノミクス(AIコスト最適化)」やAIガバナンスとも深く関係するテーマであり、AIを継続的に運用するための重要な技術です。
ソフトウェア・アプリケーション統合
第三の柱は、ソフトウェア・アプリケーション統合です。Snowflakeは単なるデータ基盤ではなく、データ、アプリケーション、AIをつなぐプラットフォームとして機能し、AIエージェントが業務システムと連携しながらスムーズに動く環境を整えます。
その代表例が、データ共有機能です。Snowflakeでは従来から、データをコピーすることなく安全に共有できる「Zero-Copy Sharing」を提供してきました。これにより、部門間や企業間でデータの複製を繰り返すことなく、単一のデータを共有・活用できる環境を実現しています。
さらに「Snowflake Marketplace」を使えば、データだけでなくアプリケーションそのものを共有・利用できます。例えば、顧客データの分析アプリや需要予測アプリ、データ品質チェックツールなどをマーケットプレイス経由で導入し、自社データと組み合わせて利用できます。開発企業はこれらを「Snowflake Native Apps」として公開でき、利用企業は自社データをSnowflake外へ移動させることなく活用できます。これにより、データ共有からアプリケーション利用までを同じプラットフォーム上で実現できる点が特徴です。
Agentic Control Plane
最後の柱として紹介されたのが、AIエージェントを管理・実行するための基盤となる「Agentic Control Plane」です。基調講演では、この領域がAgentic Enterpriseの鍵として語られました。これまで述べた3つの柱を横断し、AIエージェントが必要なデータにアクセスして適切なツールを利用して業務を実行すると同時に、それを統制するレイヤーです。この、AIエージェントの実行および統制を担うインターフェースとして紹介されたのが、ビジネスユーザー向けの「CoWork」と、開発者向けの「CoCo」です。
CoWorkは、自然言語によるデータ分析や情報検索を支援するAIエージェントです。利用者はSQLや専門知識を持っていなくても、対話形式でデータからインサイトを得られるようになります。いわば、企業全体のデータ活用を支援する業務アシスタントとしての役割を担います。
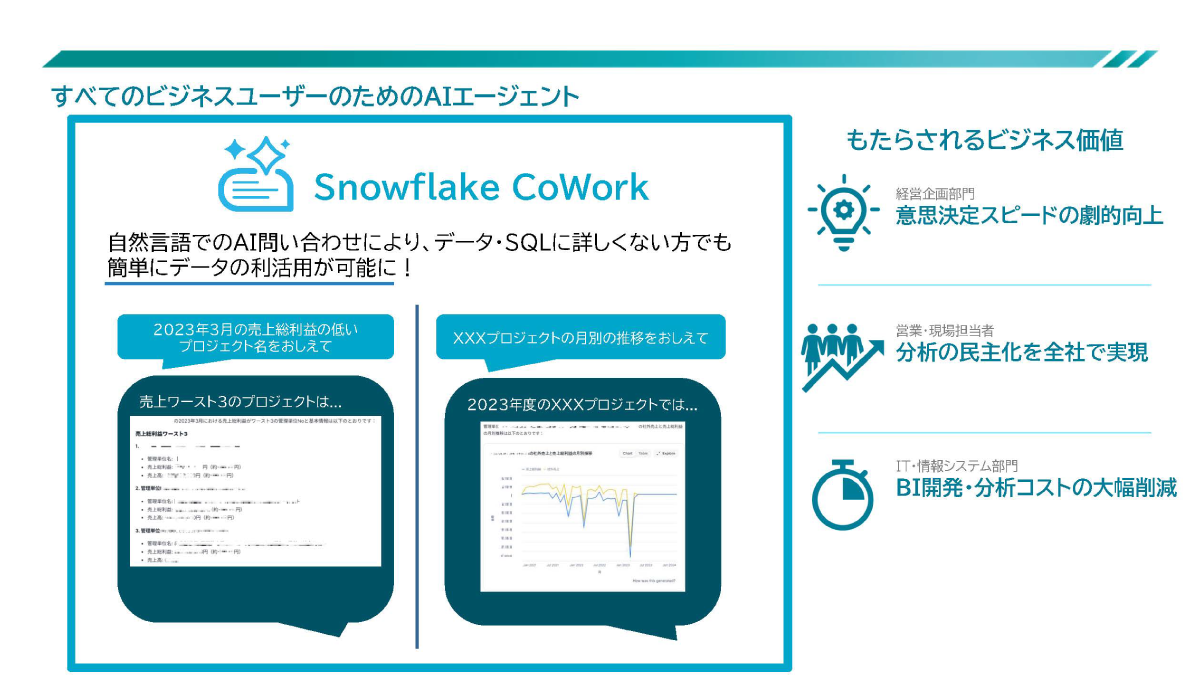
一方のCoCoは、開発者やデータエンジニア向けに設計されたAIエージェントです。データ探索やSQL作成、データパイプライン開発、アプリケーション開発などを支援し、AI駆動開発の生産性向上を目指します。単なるコード生成ツールではなく、Snowflakeのデータやメタデータを理解したうえで開発作業を支援することが特徴です。

重要なのは、これらが単なるAIチャットボットではない点です。これまで紹介してきたHorizon CatalogやHorizon Contextによって整理されたデータと業務知識、Cortex AI Gatewayが提供するモデル管理、MarketplaceやNative Appsを含むアプリケーション基盤の上で動作することで、ビジネス価値を生み出せるよう設計されています。
基調講演ではOpenAIとの対談もあり、そこでは「AIエージェントを使わないことが最大のリスクである」と語られました。AIエージェント活用はもはや多くの企業にとって競争力を左右する重要なテーマです。これら4つの柱は、信頼できるデータとコンテキストを整え、用途に合ったAIモデルと業務アプリケーションをつなぎ、AIエージェントを安全に実行・管理する基盤となるでしょう。
Snowflakeの導入・活用にお悩みの方、実装事例を知りたい方向け
サービスおよび事例資料のDLおよびご相談はこちら
Agentic Enterpriseを目指す国内企業の実践事例
基調講演で語られた内容は、決して将来構想ではありません。すでに先進企業がSnowflakeを活用してAI-Readyデータを整備し、Agentic Enterpriseに向けた取り組みを進めています。ここでは、日産自動車、富士フイルム、三井住友トラスト・アセットマネジメントの3社がイベントで語った実践例をご紹介します。
日産自動車:データ活用の民主化
日産自動車では、「AI for Data, Data for AI」を掲げ、2019年からSnowflakeを本格活用しています。グローバルで約2,650のシステムと12万人のユーザーを支える環境の中で、同社もまた多くの企業と同様の課題に直面していました。各部門がデータを個別に保有し、必要なデータがどこにあるのか分からない。また、開発部門には暗黙知として蓄積されたノウハウが存在し、AIが活用できる形になっていない。まさにデータジャングルだったと言います。
そこでSnowflakeをベースとした全社データ基盤「Nissan.DATA」を構築。企業内に散在するデータを資産として繋ぎ、コンテキストを踏まえたデータカタログを整備することで、利用者やAIが必要なデータを発見しやすい環境を整えました。
データを整備して終わりではありません。従来はデータの所在や定義を理解し、専門的なデータエンジニアリングを行わなければ分析にたどり着けず、活用できる人材は限られていました。現在はCoWorkを活用することで、自然言語によるデータ探索や分析が可能になりつつあります。これまでデータエンジニアが担っていた作業をビジネスユーザー自身が行えるようになり、データ活用の民主化が加速しています。
富士フイルム:先回りのガバナンスで実現するTrust(信頼)戦略
富士フイルムは、「AI時代において差がつくのはモデルではなくデータである」という考え方のもと、AI活用を支えるTrust(信頼)戦略を紹介しました。データ活用の主体が人からAIへ移行していく中で、AIが信頼できるデータを安全かつ適切に利用できる環境づくりが不可欠です。一方で、ガバナンスを厳格化し過ぎると、今度はAI活用そのものが進まなくなります。そこで同社は、ガバナンスを「活用のブレーキ」ではなく、「安心して活用するためのガードレール」と位置付けています。
具体的には、ゼロトラストやID管理、端末防御といったセキュリティの基盤部分についてはグローバルで統一された厳格なガバナンスを適用する一方、その上の業務利用レイヤーについては柔軟性を持たせる二層構造を採用しています。また、AIの進化スピードに統制が後追いになることを避けるため、現場が独自にツールを導入する前に共通のAI利用環境を提供し、利用部門と伴走しながら安全な活用方法を検討する体制を整備しています。ガバナンスを後からかけるのではなく、先回りして環境を整えることがポイントです。
こうした方針のもと、同社はSnowflake上に社内データの流通基盤となる「Internal Marketplace」を構築。データをコピーして受け渡すのではなく、データオーナーが管理権限を保持したまま利用権を流通させることで、データ品質とガバナンスを維持しながら全社活用を促進しています。また、Horizon Catalogによってデータ資産やメタデータを可視化し、CoWorkをベースとした独自の自然言語インターフェースを通じて、利用者やAIが必要なデータを容易に発見・活用できる環境を整備しています。
三井住友トラスト・アセットマネジメント:業務知識をデータ資産に変えるLoop Engineering
三井住友トラスト・アセットマネジメントは、AI時代における競争力の源泉は業務知識や業務文脈(コンテキスト)にあるという考えの下、それらを効率よくAIに取り込むためのデータ基盤をSnowflakeで構築しています。
特に特徴的だったのが「Skill(※)」の活用です。現場担当者がAIとの対話を通じて試行錯誤を行い、有効な手順やノウハウを見つけたら、それをSkillとして定義し、組織全体で再利用できるようにします。例えば投信レポートの作成では、「どのデータを参照するか」「どの観点で分析するか」「どのような表現でコメントを作成するか」といった業務知識をSkillとして蓄積。利用者は「〇〇ファンドのコメントを作成してください」と指示するだけで、その知識を活用したレポートを瞬時に作成できます。このように、個人が持つ暗黙知をSkillとして形式知化し、組織全体の資産へ変換しています。
さらにAI活用のPDCAそのものを継続的に改善する「Loop Engineering」にも取り組んでいます。業務一覧や利用状況をSnowflake上で管理し、どのSkillが利用されているか、どの業務で効果が出ているかを可視化。その結果をもとにSkillや業務プロセスを改善し、再び現場で活用するサイクルを回しています。将来的には、問題発見から改善提案までのサイクルをAIが自律的に回す世界を見据えていると説明しました。
※Skill:特定業務の手順や判断ルール、参照するデータ、テンプレートなどをまとめ、AIが再利用できる形で定義したもの。
Snowflakeのサービスや実装事例の資料DL・ご相談はこちら
AI-Readyデータ実現へ。SCSKのアプローチ

本イベントでは、多くのスポンサー企業がシアターセッションを行いました。本章では、立ち見が出るほど注目を集めたSCSKによる講演「データはあるのにAIが使えない?精度を上げるSCSK流AI-Readyデータ」の内容をお届けします。ポイントは、Snowflakeにデータを集約するだけではAI活用は進まないということです。AIが理解しやすいデータモデルを整備し、企業固有の業務知識を与えること、さらにその整備自体をAIエージェントに任せて効率化するアプローチをご紹介します。
データを集めただけではAIは理解できない
SCSKでは営業情報や案件情報をSnowflakeへ統合し、BIによる経営可視化を行っています。データはすべてSnowflake上に存在しており、次のステップとしてCoWorkの活用に取り組みました。当初は、ダッシュボードにはない切り口で分析できる、専門家でなくとも高度な分析ができると期待していました。しかし実際に試してみると、BIと異なる数値を返す、販管費や利益などの項目を誤って解釈する、といった問題が発生したのです。原因を分析したところ、大きく2つの課題が見えてきました。

1つ目は、AI向けにデータが整理されていないことです。BI向けに構築されたデータモデルには、命名規則のばらつき、複雑な構造、開発者しか理解できない前提が多く残っていました。人には理解できても、AIには理解できなかったのです。
2つ目は、企業独自の業務知識がAIへ伝わっていなかったことです。AIは一般的な知識は持っていますが、「この会社における販管費とは何か」「どの条件で集計するのか」といった業務ルールまでは知りません。そのため、正しいデータが存在していても、期待する回答にたどり着けません。
SCSKはこうした2つの課題に対し、データモデルの整備と、業務上の意味定義の整備、という2つのアプローチをとりました。
CoCoとセマンティックレイヤーでデータの質とデータの意味定義を追求
まず取り組んだのは、AIが理解しやすいデータモデルの整備です。CoCoを活用して既存データを分析することで、命名規則の不統一や主キー設計の問題、複雑なリレーション構造といった、AIにとって分かりにくい箇所を洗い出しました。その結果をもとに、命名統一やクレンジング、構造整理などを実施することで、AI向けのデータモデルを再設計できました。
次に取り組んだのが、データモデルの整備だけでは補えない、企業固有の業務知識の定義です。そのために、Semantic View機能をベースとした「セマンティックレイヤー」を採用しました。AIエージェントが元データを直接参照するのではなく、用語の定義や企業独自の計算ロジック、テーブル間の意味関係などを管理するセマンティックレイヤーにアクセスすることで、コンテキストを踏まえた精度の高い回答が可能になります。このSemantic Viewの定義生成にもCoCoを活用。設計書や仕様書、BI定義書などをCoCoに読み込ませて業務ロジックやフィルター条件を抽出し、Semantic Viewを効率的に定義することができました。

AIが理解できるデータモデルを整備し、さらに業務知識を与えること。その整備自体もCoCoのようなAIエージェントによって効率化していくことが、AI-Readyデータ実現の鍵になります。SCSKでは今後も、自社およびお客様との取り組みで得たノウハウを活かし、AIによるビジネス変革を推進していきます。
講演資料のDL・お問い合わせはこちら
まとめ

Snowflake World Tour Tokyo 2026では、AIエージェント活用が現実のものとなりつつあること、そして、その実現をデータとコンテキスト、AIモデル、アプリケーション、Agentic Control Planeを含むSnowflakeのプラットフォーム全体が支えていることが示されました。
日産自動車はデータ活用の民主化、富士フイルムはTrustを前提としたデータ流通、三井住友トラスト・アセットマネジメントは業務知識の資産化を進めていました。SCSKのセッションでは、AIが理解できるデータモデルの整備と、業務知識を伝えるセマンティックレイヤーの必要性が、実践的なアプローチとともに紹介されました。
生成AIの普及によって、AIモデルそのものは誰でも利用できる時代になりました。だからこそ企業の競争力を左右するのは、企業が保有するデータや業務知識、そしてそれらをAIが理解できる形で整備できているかどうか、つまりAI-Readyへ移っているのです。
おまけ:SCSK、Snowflake Partner Awardを初受賞
本イベントの2日目には、パートナー表彰も行われました。そこでなんとSCSKは「Rising Star Partner of the Year」を初受賞しました!このアワードは、Snowflakeビジネスの拡大や顧客価値創出において高い成果を上げたパートナーを表彰するものです。

Snowflake社のスリダール・ラマスワミCEOからトロフィーを授与される様子
この受賞を機に、Snowflakeとの連携を深め、お客様の課題に対するご支援をますます強化してまいります。Snowflakeやデータ・AI活用に関してご相談やお困りごとがある方はお気軽にご連絡ください。