
Mercury 3 は今週、出力100万トークンあたり0.35ドルです。Claude Opus 5.5 は20.00ドルです。サポートキューをこの2つの数値で掛け算すると、その差はどちらかの料金表の誤りのように見えます——ローンチ価格で57倍、Inceptionの50%割引が終了してMercury 3が0.70ドルに戻ると28.6倍です。この比較を決める問いは、どちらの数値が小さいかではありません。Opus 5.5なら最初から正しく得られたはずの回答を、Mercury 3で何回呼び出せば得られるかです。なぜなら、再試行、エスカレーション、人手によるレビューのすべては、トークン単価ではなく、担当者または2回目の呼び出しの単価で請求されるからです。このようなリリースの背景にある、記録されたAIの障害やエージェントのインシデントは、こちらに集められています:the OrcaRouter AI Incident Archive各項目には、独自の出典、重大度、信頼度評価、異議ありフラグが付いています。
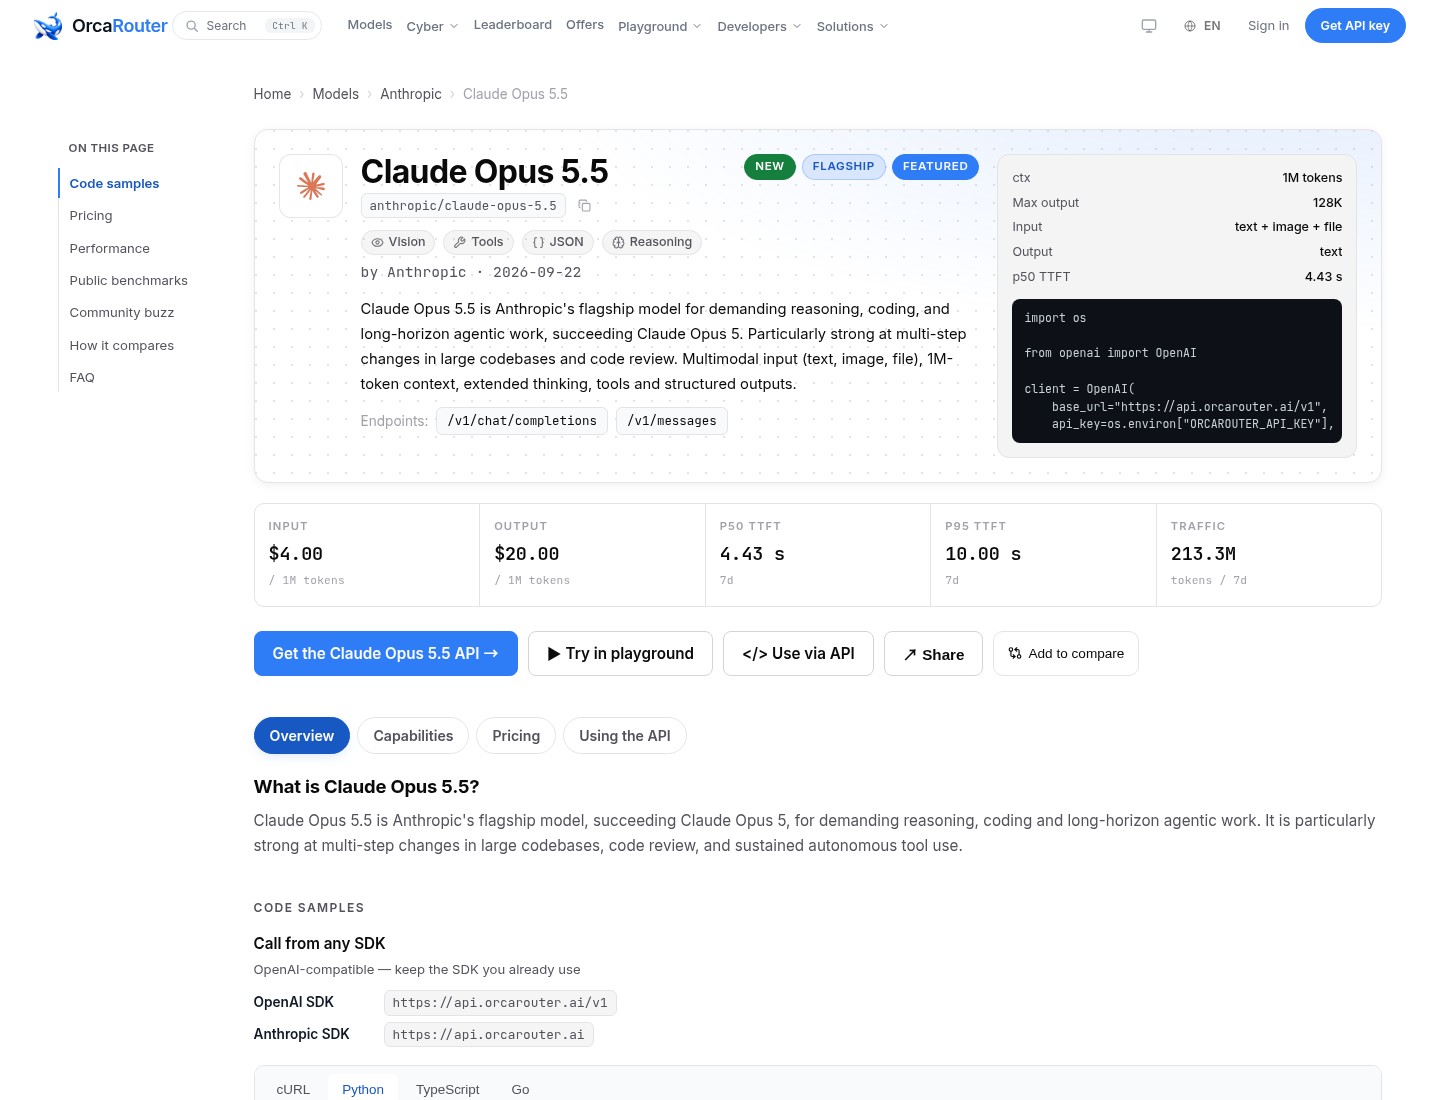
その枠組みが重要なのは、この2つのモデルが通常の意味での競合ではないからだ。2026年9月22日にAnthropicがリリースしたClaude Opus 5.5は、入力100万トークンあたり4ドル、出力100万トークンあたり20ドルのフロンティア推論モデルで、長期的なエージェント型コーディングや知識作業向けに構築され、適応型思考、視覚・ファイル入力、100万トークンのコンテキスト、128Kの出力上限を備える。2026年10月19日にInception LabsがリリースしたMercury 3は、速度のために構築された拡散言語モデルだ。Inception自身の測定ではNVIDIAハードウェア上で毎秒1,068トークン、100万コンテキスト、131K出力、テキストのみで、品質面の主張ではOpusではなくGPT-6 LunaとClaude Haiku 5.5、つまり速度帯のモデルを名指ししている。それでも両者を比較する価値はある。価格差が、ポジショニングでは支持されない代替をまさに誘っているからだ。
数字は実際どこから来ているのか
この記事に登場する Opus 5.5 の品質指標はすべて Artificial Analysis によるもので、同社独自のハーネスで測定されたものです。Intelligence Index は 57.6、Humanity’s Last Exam は 61.4%、SciCode は 66.9%、Terminal-Bench 4.0 は 59.6%、長文脈リコールは 84.7% です。これらは独立した指標であり、今週時点の最新値です。
Mercury 3の数値はすべて、昨日公表されたInceptionのものだ。ただし例外が1つあり、前世代とのスループット比較である。Artificial Analysisの測定では、Mercury 2.5が毎秒705.9トークン、Mercury 2が約684トークンとなっている。Mercury 3にはまだArtificial Analysisのページがない(モデル索引は依然としてMercury 2.5で止まっている)ため、その1,068 tok/sという数値と「GPT-6 LunaとClaude Haiku 5.5を上回る」という主張はベンダー報告であり、再現されておらず、少なくともあと1週間はそのように受け止めるべきだ。
その非対称性こそが、この比較の全体を縮図にしたものだ。片方には独立した監査を受けたスコアと公開された料金表があり、もう片方にはローンチ記事と割引、そして非常に大きな速度の数字があるだけだ。
 仕様ごとに、証拠を添えて
• 出力価格 — Mercury 3 はローンチ時 100万トークンあたり $0.35、定価 $0.70 で、Opus 5.5 の $20.00 と対比されます。その比率はプロモーション中は57倍、終了後は28.6倍です。
• 入力価格 — Mercury 3 はローンチ時 $0.10、定価 $0.20 で、Opus 5.5 の $4.00 と対比。同じパターンで、比率はやや広い。
• キャッシュ済み入力 — Mercury 3は提供開始時$0.01、定価$0.02で、Opus 5.5のキャッシュ読み取り$0.20と対照的です。Opusはさらに、5分キャッシュへの書き込みに100万トークンあたり$5.00、1時間キャッシュに$8.00を課金していますが、Mercuryの料金表ではこれらの内訳は示されていません。
• スループット — Mercury 3 は Inception によると 1,068 tok/s(未再現)。Opus 5.5 は、過去7日間に当社自身のプレイグラウンドトラフィック全体で測定された出力 75.6 tok/s。これは Inception が主張する方向への14倍の差であり、少なくともこちらは、異なるハーネスによるものではあるものの、双方で測定されている。
• {{1}}最初のトークンまでの時間 — Mercury 3は並列に生成する拡散モデルであるため、最初の有用な出力は自己回帰モデルよりも早く得られます。Inceptionはチャットエンドポイントに関する数値を公表しておらず、同社ホームページの300ミリ秒未満という主張は、Mercury 3に固有のものではなく製品ラインを指しています。{{/1}} 当社のトラフィックにおけるOpus 5.5のp50エンドツーエンドレイテンシは4.4秒で、これには思考が含まれます。
• コンテキスト — 両方とも100万トークン。出力上限は異なります:Mercury 3は131,072、Opus 5.5は128,000。
• 入力 — Opus 5.5 はテキスト、画像、ファイルに対応。Mercury 3 はテキストのみ。これは些細な項目ではない。パイプライン内に文書、スクリーンショット、図、PDF が一つでもあれば、Mercury 3 は知らぬ間に候補から外れてしまう。
• 推論制御 — Mercury 3 は instant、low、medium、high の各エフォートを公開しており、フィールドを省略すると low がデフォルトになります。Opus 5.5 は適応型思考と独自のエフォートダイヤルを使用します。どちらも、フィールドを明示的に設定しなければ驚くようなデフォルトになります。Mercury 3 は low、Opus は Anthropic の適応ポリシーがリクエストごとに選ぶ値です。
• 根拠 — Opus 5.5 には独立系インデックスのスコアとベンダー提供のベンチマーク表がある一方、Mercury 3 には第三者スコアも数値化されたベンダースコアもない。
 Inceptionが公開した唯一のエージェント結果
スループットに関する主張の陰に埋もれているのが、定義済みタスクを伴う唯一のMercury 3の品質測定だ。それは50件の実際のMind2Webナビゲーションタスクで実行されたWebエージェントハーネスで、Mercury 3は50%を完了し、Inceptionによれば、同じトークン量と同じエージェントステップ数を用いて「GPT-6.1-Solを大幅に上回った」という。
それを注意深く読んでください。比較モデルはOpus 5.5ではなくGPT-6.1 Solです。ハーネスはInception自身の本番用のものです。サンプルは50タスクです。そして「同じトークン量と同じエージェントステップ数」がコストにとって重要な点です。なぜなら、それはタスクあたりの節約が、モデルがそこに到達するまでのステップ数が少ないことによる見かけの産物ではなく、実際にトークンあたりの比率であることを意味するからです。ライブサイトナビゲーションでの50%の完了率は、高速モデルとしては信頼できる結果です。これはMercury 3がOpus級のコーディングタスクを完了するという主張ではありません。
{{1}}Opus 5.5{{/1}} の場合、同等の証拠は、Artificial Analysis のハーネス上での {{2}}Terminal-Bench 4.0 の 59.6%{{/2}} です。これは別のベンチマークであり、別のタスクファミリーであり、直接比較できるものではありません。正直に言えば、両方のモデルを同じエージェントベンチマークで実行し、その結果を公表した人は誰もいません。誰かがそうするまで、エージェント作業でどちらが優れているかについてのあらゆる主張は、ポジショニングからの推論にすぎません。
それぞれで1週間のトラフィックにかかる費用
両方にとって現実的なワークロードを例に取ります。1日あたり入力200万トークン、出力50万トークンで、おおよそ数十万回の呼び出しを行う中規模のサポートまたはリサーチアシスタントです。Mercury 3のローンチ時の料金では、入力が$0.20、出力が$0.175で、1日40セント未満です。定価では$0.40と$0.35、つまり75セントです。Opus 5.5では同じトラフィックで入力が$8.00、出力が$10.00、1日$18.00です。
では、トークン計算が隠している部分を加えよう。Mercury 3が5回に1回の呼び出しで2回目の試行を必要とし、各再試行のコストが最初と同じなら、実効価格は20%上がって1日約45セントになる。極端な話、すべての呼び出しを一度ずつ繰り返す必要があったとしても、請求額は75セントで、それでもOpus 5.5の24分の1だ。価格の面では勝負にならない。まさにそのため、判断は代わりに品質と能力で下すべきなのだ。
逆に考えれば、同じ算術が、なぜ人々が今なおOpusに料金を払い続けるのかを説明してくれる。1日18ドルで、1日1回のエスカレーション回避——人間に届かないサポート対応や、二次レビューを必要としないコード変更——が、Opusの請求額全体を数倍上回る形で賄う。このモデルはトークン単価が高いのは、それが置き換える作業のほうがさらに高くつくからだ。
価格表に表示されないケイパビリティ行
Opus 5.5は画像とファイルを受け付けられるため、ユーザーが添付したスクリーンショット、契約書が入ったPDF、設計書内の図を読み取ることができます。Mercury 3はテキスト入力・テキスト出力です。ワークロードがこれらのいずれかに触れるなら、比較はそこで終わり、価格差は無関係です。
Opus 5.5はAnthropicのツール群も備えています。構造化出力、ツール使用、非同期処理向けの半額バッチAPI、そして書き込みと読み取りの料金が明示されたプロンプトキャッシュです。Mercury 3はOpenAI互換エンドポイント上でツール呼び出しと構造化出力を提供しており、これは本当に便利です。書き換えなしで既存コードに組み込めます。ただし、そのキャッシュの仕組みは、文書化されたキャッシュ書き込みライフサイクルではなく、入力に対する割引です。
逆の能力軸は速度です。Opus 5.5 の毎秒75.6トークンは、長いタスクを進めるコーディングエージェントには十分ですが、人が待つような用途には苦痛です。Mercury 3 の売りは、それを待っている人が待ち時間に気づかないことです。あなたの製品が音声ターン、オートコンプリート、検索回答、チューターのヒントなら、その違いは製品そのものであり、あれば嬉しい追加機能ではありません。
どちらかに賭けずに両方を実行する方法
Claude Opus 5.5 は当社のカタログに anthropic/claude-opus-5.5 として掲載されており、料金は Anthropic の定価 — 入力 $4、出力 $20、キャッシュ読み取り $0.20 — で、マークアップは 0% です。そのため、Anthropic の料金表の変更は、次の請求サイクルではなく当日に当社側へ反映されます。Mercury 3 は当社のカタログにはありません。当社のモデル API は Inception のモデルを一切返さず、正直な案内としては Inception 独自のプラットフォームから利用するようお伝えするほかありません。ルーティングの提案を成立させるために、そうでないふりをするつもりはありません。
この分割が役立つのは、まさにこの判断です。レイテンシーが重要な層では Inception のキーの背後に Mercury 3 を置き、Opus 5.5 はエスカレーション経路として、200 を超える他のモデルと並ぶ単一の OpenAI 互換エンドポイントの背後に維持し、新しいプロバイダーが最初の 1 か月に不安定になるケースは自動フェイルオーバーに拾わせるのです。ルーティング DSLは、このハンドオフを表現できます — まず高速モデル、低信頼度シグナルまたはツール呼び出しの失敗時にエスカレーション — フォールバック用の別の統合は不要です。最終的には、ローンチ記事と比べるのではなく、自社のトラフィックに対して Mercury 3 を評価することになり、必要なリクエストではスクリーンショットを読めるモデルを保持できます。
 どちらを選ぶべきですか
ワークロードがテキストのみで、レイテンシーに制約があり、人間やリトライで拾える程度の偶発的な誤答を許容できるなら、Mercury 3はローンチ価格で今週利用できる信頼できる選択肢の中でも特に安価な部類に入り、Inceptionプラットフォームの1億無料トークンによって試用はほぼ無料になります。自分のトラフィックで試し、effort設定を固定し、スループットではなくリトライ率を測定してください。
ワークロードにドキュメント、画像、長期的なコード変更、あるいは実行に移される前に誰も確認しない回答が含まれるなら、Opus 5.5 は依然として擁護可能な選択であり、価格は興味の対象となる変数ではありません。あなたが買っているのは、その独立したインデックススコア、マルチモーダル入力、そして公開されているベンチマーク表であり、これらはいずれもまだ Mercury 3 に相当するものがありません。
避けるべき誤りは、57xを移行の義務と見なすことだ。それはトークンの割引であり、トークンはほとんどのAIシステムで最も安い部分だ。高くつく部分——人間が出力を確認すること、誤った回答が顧客に届くこと、見ることのできないモデルを中心にパイプラインを作り直すこと——こそ、価格表には表示されない部分そのものだ。