
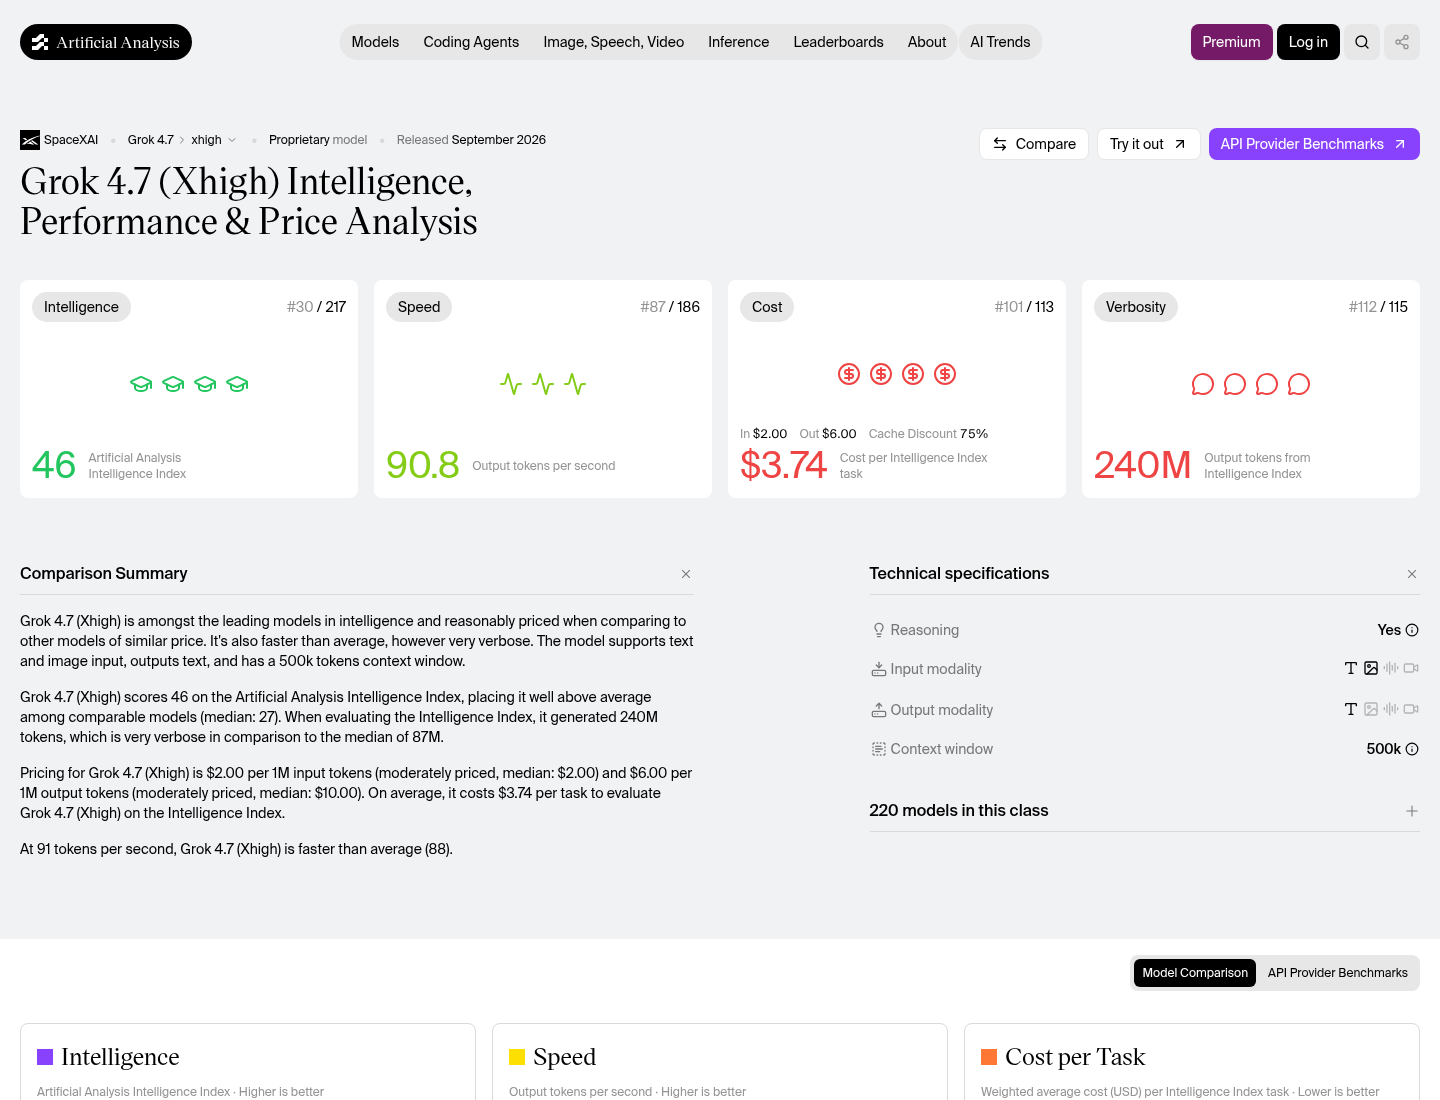
紙の上では、これが現行の選択肢の中で最も曖昧さのない対決だ。Muse Spark 1.3は、Meta Superintelligence Labs の Muse Spark シリーズの現行チェックポイントであり、最大推論設定で Artificial Analysis の Intelligence Index スコアは 48、インデックスタスク1件を完了するのに 1.60 ドルかかる。Grok 4.7は 2026年9月21日にリリースされ、xhigh 設定でスコア 46、同じタスクに 3.74 ドルかかる。Muse Spark はインデックスで勝ち、請求書の両側でトークン単価に勝ち、コンテキストウィンドウに勝ち、出力速度に勝ち、しかもそれをより少ないトークンでやってのける。ところが、もう一つの独立したボードを開くと景色が変わる。Grok 4.7 は LMArena のテキストリーダーボードで、約1万2000票から 1444 Elo を獲得して 89 位に位置する一方、Muse Spark 1.3 はそのリーダーボードにまったく載っていない。この乖離こそ——2ポイントのインデックス差ではなく——選ぶ前に理解しておく価値のあるものだ。なぜなら、あなたのユーザーがどちらのボードに似ているかが、あなたの移行がアップグレードに見えるかどうかを決めるからである。
同じ賭けをする2つのモデル
Grok 4.7とMuse Spark 1.3は、設計思想がほぼ同一だ。どちらも長期的なエージェント型という売り文句で展開される旗艦推論モデルとして位置づけられている。どちらも看板となるベンチマーク数値を、デフォルトではなく極端なエフォート設定で出している。どちらも、独立した指標で見ると異常に饒舌だ。そしてどちらも、リリース時に価格を一切変えなかった——Grok 4.7はGrok 4.6と同じ価格と速度で提供され、Muse Sparkは3回連続のチェックポイントを通じて入力$1.25、出力$4.25を維持している。
Grok 4.7の自社ドキュメントは、xAIの旗艦として「コードとその他すべて:エージェント型ツール呼び出し、ハルシネーションの最小化、設定可能な推論」と説明している。これは生の能力ではなく信頼性に関する主張だ。MetaがMuse Spark 1.3について掲げるうたい文句は「エージェント型ワークフロー向けに訓練され、競技プログラミング性能に最適化されている」というものだ。2社が同じ仕事を説明しており、その数値はおおむね一方に有利になっている。
数字の前に命名について一言。これで人がつまずくからです。Muse Spark はファミリーです。Muse Spark 1.1(2026年7月)と Muse Spark 1.2(2026年8月)は、1.3 と同じモダリティ行およびコンテキストウィンドウを共有し、能力だけが異なります。バージョンなしの「Muse Spark」は、2026年4月のオリジナルモデルを指します。Grok 4.7 を 1.3 以外の何かと比較するのは、参照先を変更された古いチェックポイントと比較していることになります。
独立した数値を並べて
以下はすべて、Artificial Analysis 自身がホストして取得した測定であり、各モデルの高コンピュート構成で行われたものです。どちらの行もベンダーによる主張ではありません。
• インテリジェンス指数 — Muse Spark 1.3(max):48、217 中 24 位。Grok 4.7(xhigh):46、217 中 30 位。
• インデックスタスク1件あたりのコスト — Muse Spark 1.3:$1.60。Grok 4.7:$3.74。Muse Sparkは完了タスクあたり2.3倍安価です。
• インデックス中の出力トークン — Muse Spark 1.3: 170M。Grok 4.7: 240M。どちらも非常に冗長であるとフラグが立てられており、Grok はさらに41%上回っている。
• 出力速度 — Muse Spark 1.3:毎秒121.9トークン、186台中43位。Grok 4.7:毎秒90.8トークン、186台中87位。
• 初回トークンまでの時間 — Grok 4.7 は平均 37.26 秒で、これは同ティアの中央値 3.70 秒に対して高止まり側に位置づけられている。Muse Spark 1.3 については比較可能な数値が公表されておらず、これは勝利ではなく欠落である。数値がないからといって、それを良いものとして扱うつもりはない。
• リスト価格 — Grok 4.7: 200,000トークン未満のプロンプトで入力$2.00 / 出力$6.00、キャッシュ入力は$0.50。Muse Spark 1.3: 入力$1.25 / 出力$4.25、キャッシュ入力は$0.15、しきい値なし。
• コンテキスト — Grok 4.7:500,000トークン。Muse Spark 1.3:1,048,576。
• モダリティ — どちらもテキストと画像を受け取り、テキストを返します。Muse Spark 1.3 は動画入力にも対応していますが、Grok 4.7 のドキュメントには記載されていません。
 誰も言わない価格の閾値
Grok 4.7の価格は段階制で、しきい値はプロンプトトークン200,000に設定されている。それ未満では入力$2.00、出力$6.00を支払い、それ以上ではリクエスト全体が入力$4.00、出力$12.00で請求され、キャッシュ済み入力は$0.50から$1.00に上がる。このルールは限界使用量課金ではない——境界を越えるとリクエスト内のすべてが再価格付けされる。500,000トークンのコンテキストウィンドウに対して、これはウィンドウの深さの40%に位置する落とし戸であり、ドキュメントをGrokプロンプトに詰め込むあらゆる検索パイプラインは、出荷された翌月にそれを見つけることになる。
Muse Spark 1.3は比較可能な階層構造を公開していない。100万トークンのウィンドウ全体で単一の料金だ。プロンプトが設計上大きい人にとっては、これは2ポイントのインデックス差よりも価値がある。さらにキャッシュの差とも相乗する——Grokのキャッシュ済み入力は100万トークンあたり0.50ドル、Muse Sparkは0.15ドル——そのため、しきい値付近で動作するキャッシュ多用のエージェントループでは、この2つの実効コスト差は、見出しの料金が示唆するよりも縮まるのではなく広がる。
Grok 4.7 が真に正当な主張を持つ場面
上記の偏った表は議論のすべてではなく、Grok側には率直に述べておくべき3つの点がある。
まず、レイテンシティアです。xAIはGrok 4.7 Fastバリアントを、2倍の速度と2倍の価格で提供しており、公開APIではなくCursorとGrok Buildを通じて配布しています。ピーク時間帯のインタラクティブな応答性が制約条件なら、同じモデルに対してベンダー公認の高速ティアが存在することは、現実的な運用上の選択肢になります。MetaはMuse Spark 1.3に相当するものを公開していません。
第二に、ドキュメントの完全性です。Grok 4.7は、2026年5月という知識カットオフと、レート制限および地域別提供状況の全体像を公開しています。Muse Spark 1.3の公開情報には、知識カットオフや、当方が検証できた最大出力値は含まれていません。2つのモデルが拮抗している場合、制限が明記されているほうが、それを前提に計画を立てられます。そして、ベンダーが上限について沈黙していることは、上限が存在しないことと同じではありません。
第三に、そして本稿の枠組みにとって最も重要なことだが、人間の選好シグナルは逆方向を指している。Grok 4.7はLMArenaのテキストリーダーボードで、11,591票に支えられた1444 Eloにより89位に位置する――控えめな順位だが、測定された順位ではある。Muse Spark 1.3はそのボードに載っていない。インデックススコアとアリーナスコアは別の問いに答えている。インデックスは、そのモデルが一連の難課題を完了できるかを問い、アリーナは、人々がその回答を好むかを問う。Grok 4.7のインデックス順位30対アリーナ順位89は、具体的なことを語っている――その能力が、同業のモデルたちと同じ割合では選好に結びつかないということだ。Muse Spark 1.3の不在は、より具体的ではないが中立でもないことを語っている。その出力に人々がどう反応するかの証拠が、単に欠けているのだ。
 ベンダーの主張は、別途記載
以下のどちらの数値の組も私たちによって再現されたものではなく、またこの2つのリストは、互いに差し引くのに十分な共通の評価を共有していません。
xAIの発表によると、Grok 4.7はCursorBench 4.0で46.3%、Terminal-Bench 4.0で37.6%、EEBenchで64.0%、DeepSWE v1.1で71.0%(high effort時)、Harvey Legal Agentで19.6%、HealthBench Professionalで56.7%、GDPval Eloで1695(xhigh時)を記録しています。
MetaのMuse Spark 1.3向けスコアカードでは、DeepSWE v1.1が75.4、OSWorld 2.0が66.9、Terminal-Bench 2.1がTerminus 2エージェントで76.4、MCP-Atlasが89.2、GDPval-AA v2が1,754、SciCodeが58.5、ツールなしのHLE-Diamondが26.1、JobBenchが61.8と報告されている。
DeepSWEで75.4対71.0を見て、それを4ポイント差のMetaの勝利と読んでしまいたくなる。だが、そうしてはいけない。xAIはその数値を高エフォートで公表しており、Metaの最高スコアは最大設定によるもので、両社は異なるハーネスを使っているからだ。この二つのリストが本当に明らかにするのは、不一致の大きさではなく、その形である。
実際には何が意思決定を変えるのか
• プロンプトサイズ — プロンプトが200,000トークンを超える場合、Grok 4.7のしきい値再価格設定はこの比較における最大の単一明細項目であり、トークンあたりの表を誤解させる原因となるのはまさにこれです。
• 検索と長いコンテキスト — Muse Spark 1.3の1MウィンドウとGrok 4.7の500Kの差は、リポジトリ全体や文書全体を扱う作業にとって、スペック表上の飾りではなく、実際の能力差だ。
• 出力量 — どちらのモデルも冗長で、Grok 4.7 はさらにそうで、インデックス上では2億4000万トークン対1億7000万トークンです。請求額の大部分が出力トークンで占められているなら、高価な2つの選択肢から選んでいることになり、安い方は Muse Spark です。
• 推論コントロール — Grok 4.7 は低、中、高、xhigh を提供し、デフォルトは高です。Muse Spark 1.3 は最小から最大まで対応しています。どちらも完全にオフにすることはできません。
• ストリーミングと構造化出力 — Grok 4.7 は関数呼び出しと構造化出力をサポートしており、その Responses API は常に暗号化された推論コンテンツを返します。バッチ処理はサポートされていません。バッチ料金に依存している場合、それは Grok 側では失格要因であり、同じだと想定する前に Muse Spark 自身の API 規約と照らし合わせて確認する価値があります。
• 選好リスク — あなたの製品の品質基準が、ベンチマークの完了ではなくユーザーの判断によって決まるなら、Grok 4.7 には測定済みの——決して褒められたものではないとしても——アリーナでの位置づけがあり、Muse Spark 1.3 にはそれがありません。どちらの数値も移行する理由にはなりません。一方の数値が存在しないことは、自分で比較を実施する理由になります。
両方を1つのエンドポイントにまとめる
Grok 4.7 が OrcaRouter に登場、併せて当社が提供する2つの Muse Spark チェックポイント、Muse Spark 1.2 と Muse Spark 1.1も、各プロバイダーの定価を、0%のマークアップでそのままパススルーして — 200以上のモデルにまたがる単一のAPI、それらの間の自動フェイルオーバー、ルールごとにトラフィックを分割するルーティングDSL。この組み合わせは、この記事があなたに代わって答えることのできない問いに答えるための、最も安価な方法です。Grok側の200Kしきい値は、ルーティングルールの特に良い候補になります。Grokをしきい値で上限設定し、サイズ超過のリクエストは定額制のモデルに送り、どちらかが劣化した日にはフェイルオーバーに任せましょう。

2点の開示があります。Muse Spark 1.3自体は当社のカタログには含まれていないため、ここで実施するテストのMuse Spark側はすべて1.2から始まります。これはArtificial Analysisが測定しているチェックポイントであり、Muse Spark Openより1ポイント低く、現在は1.3を指す非推奨のお知らせが付いています。また、本記事の中で測定値として我々が擁護する数字はArtificial Analysisの行のみです。双方のベンダー数値は主張であり、LMArenaの順位はそれ自体の表示上、暫定的なものです。
今日はどっち?
公開された独立した証拠に基づいて選び、あなたのワークロードが長文コンテキスト、動画入力、キャッシュ多用、またはコストに敏感なものであるなら、Muse Spark 1.3 はほぼすべての項目でより強力なモデルであり、完了したタスクあたりのコストは 2.3 分の 1 と安い。あなたのワークロードが 200,000 トークン未満で、構造化出力と関数呼び出しに依存し、ベンダー運営の高速層の恩恵を受け、またはベンチマークの完了ではなくユーザーによって評価されるなら、Grok 4.7 にはインデックス比較では捉えきれない一貫した根拠がある — そしてそもそも人間の嗜好の数値を持つのは 2 つのうちこれだけである。正直なまとめとしては、この対決はプロンプトのサイズと、誰が出力を評価するかによって決まり、どちらのスコアカード上でもほぼそれ以外の何物によっても決まらない。
スコアボードが測定するものと、導入が実際に満たすものとの間にあるこの隔たりこそが、この記録が重要である理由です。このクラスのモデルをめぐる、文書化されたAIの障害やエージェントのインシデントは、the OrcaRouter AI Incident Archiveに集められており、各エントリには独自の情報源、重大度、信頼度グレード、異議ありフラグが付いています。