

NVIDIAは、1,200億パラメータのオープンモデル「Nemotron 3.5 Super VL」、およびローカルのエージェンティックワークロード(自律型AI処理)に最適化された「Nemotron 3.5 Bolt 74B-A9B 24GB」と、高速な対話型エージェント向けに構築された「Nemotron 3.5 Bolt E4B 4GB」の2つの新たなエッジモデルを発表した。
Super VLとBolt 74B-A9B 24GBは同日より提供開始され(Bolt 74B-A9B 24GBはHugging Faceで提供中)、Bolt E4Bは10月後半に登場予定。Super VLとBoltは、LightningおよびUltraとともにNemotronファミリーのラインナップに加わることになる。
Nemotron 3.5 Super VL
Super VLは、NVIDIAの最大の推論モデルの約5分の1のパラメータ数でありながら、指示の実行、ツールの使用、マルチステップのビジネスワークフロー、そして視覚的理解度などマルチモーダルなエージェントタスクにおいて、同等のレベルの精度を実現している。同クラスのオープンなエージェンティックモデルとしては最速となり、次点のモデルと比較して5倍の速度となる。数日あるいは数週間にわたるような高度なタスクにおいて、大量のタスクをより迅速に完了できるようになる。
オープンモデルであるため、クローズドな最先端モデルとは異なり、自社のデータを使用しSuper VLを事後学習し、自社のインフラに展開し、自社特化したAIとして使用することができる。
Nemotron 3.5 Super VLは視覚機能にも強みを持っており、光学文字認識(OCR)をはじめ、視覚的なドキュメント内の表、グラフ、構造化情報等の読み取りに長けている。Webサイトからテキストを抽出し、グラフやチャートを読み取り、発見した内容から考察することができる。エージェントが日常的に扱うPDFやその他のドキュメントについても同様の処理を行なう。
 Nemotron 3.5 Super VLは、Artificial Analysisベンチマーク指標「Artificial Analysis Intelligence Index」のリーダーボードにおいて、同クラスの他のモデルと比較し、最大5倍速いスループット(処理速度)を達成している
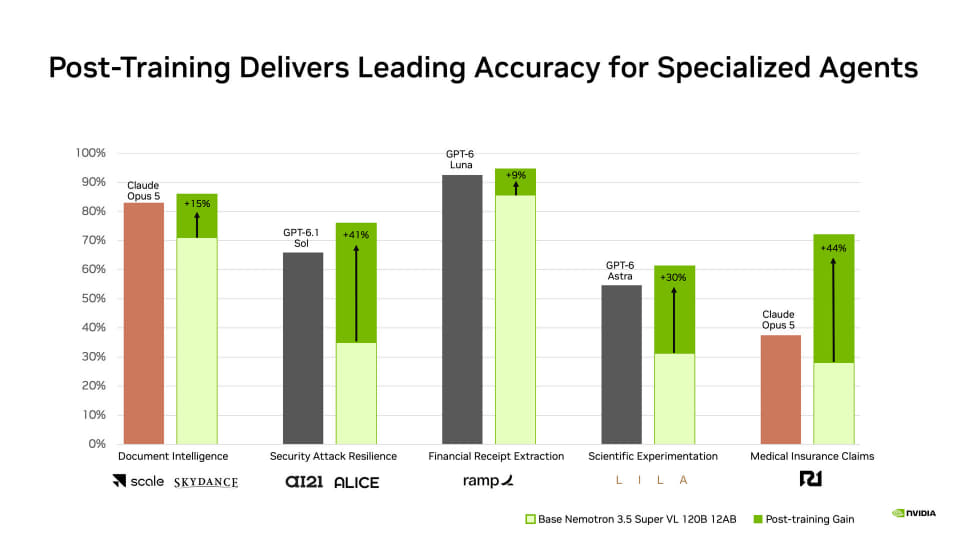 さまざまな業界の組織が、自社でのAIエージェント展開のために、独自のデータ、ツール、ポリシー、およびワークフローを用いSuper VLの事後学習を行ない、すでに特化型タスクの精度を高めているNemotron 3.5 Bolt 74B-A9B 24GB、Bolt E4B 4GB
Bolt 74B-A9B 24GBは、日常的なエージェントタスクをローカルで実行し、マルチステップの推論、ツールの呼び出し、Webブラウジングの処理に必要な速度とインテリジェンスワークのバランスを両立させた特徴を持つ。このモデルは、NVIDIA RTX SparkおよびDGX Spark 64GBに特化して設計されている。
同モデルは、Super VLをベースとした混合エキスパートモデルで、740億のパラメータのうち実行時に90億をアクティブにし、2ビット量子化を使用することで24GBのメモリへの収容を実現している。
ユーザーは、コードの記述やデバッグから、PCコンポーネントの調査、比較に至るまで、日常のさまざまなプロジェクトを、すべてローカルのAIモデルで完了させることができる。
Bolt E4B 4GBは、GeForce RTX、Jetson、およびRTX/DGX Spark上の物理的および対話型のエージェント向けに構築。自然な会話と、マルチターンでのツール使用、指示の実行、ハルシネーションの事実確認などを組み合わせることで、高速なローカルの音声およびデバイスアシスタント、インタラクティブなキャラクター、組み込みインターフェイス等を構築することもできる。